NavTorá lee cada columna con una red neuronal chica que corre en el teléfono (cómo la usa, paso a paso, está en Cómo NavTorá sabe en qué columna está abierto el sefer). Para que una red aprenda a leer, hacen falta muchos renglones junto con el texto que dicen. Como no existe un conjunto de fotos de sifrei con su texto, lo armamos por computadora.
Un script, synth.py, toma un pedazo de una columna real del formato estándar, lo escribe con una fuente hebrea y después lo envejece hasta que parece una foto sacada con el teléfono.
Una foto, paso a paso
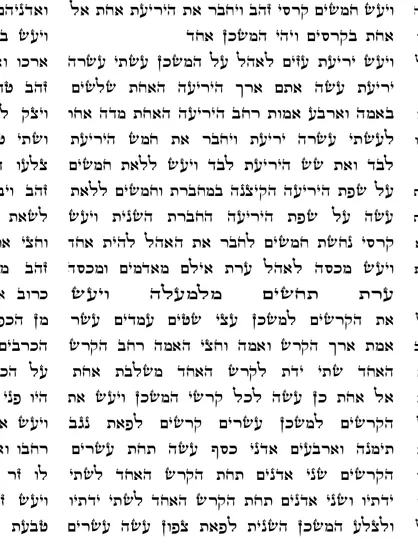
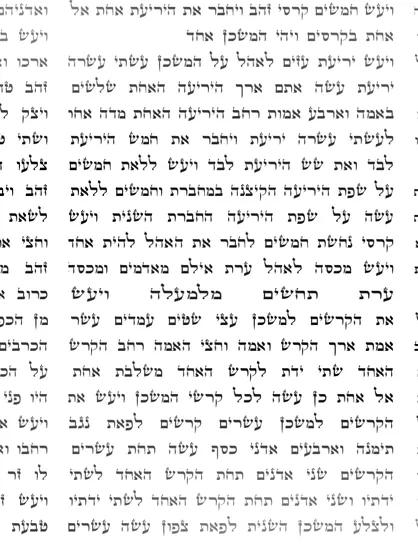
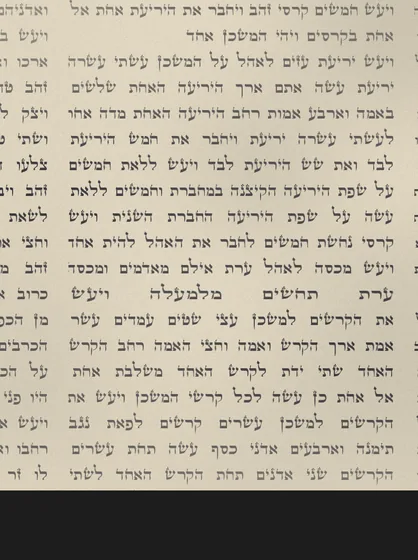
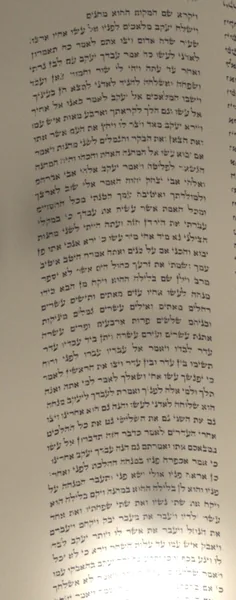
Esta es una de las primeras fotos del set de entrenamiento. Es un pedazo de la columna 105, en Vaiakhel, escrito con la fuente Stam Sefarad. Cada paso le suma algo que pasa en una foto real.
1El texto
2La tinta
3El pergamino
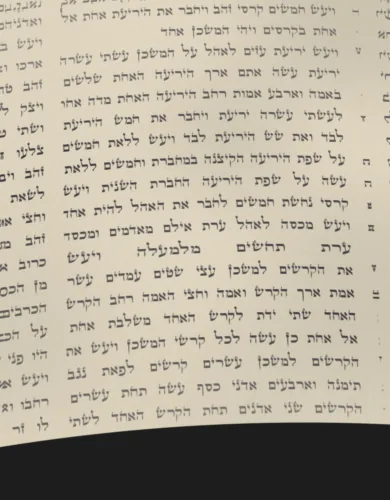
4La cámara
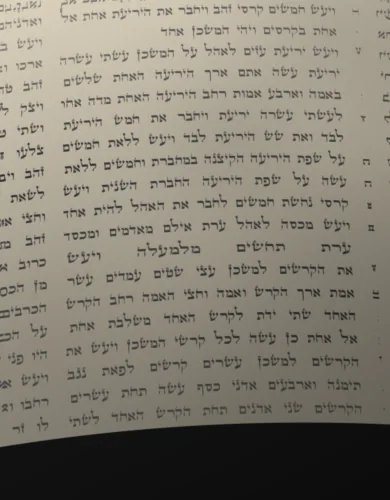
5La luz
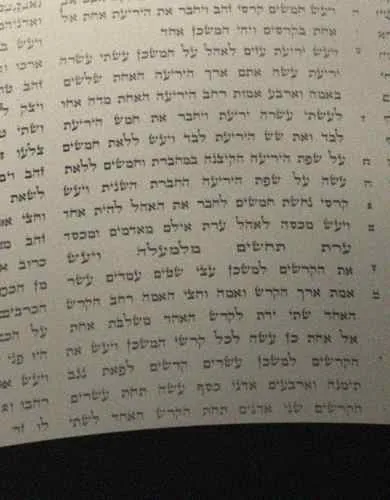
6La foto final
- El texto: los renglones de la columna, justificados como en un sefer, con partes de las columnas vecinas a los costados.
- La tinta: trazos más gruesos o más finos, partes desteñidas y pequeñas grietas en las letras.
- El pergamino: uno de siete colores de fondo, con textura y manchas, y uno de cinco colores de tinta. A veces se suma una franja oscura arriba o abajo, como el borde del rollo o la mesa.
- La cámara: perspectiva, un giro chico y la curva del pergamino. También se achica la foto, para que los renglones queden a entre 14 y 48 píxeles de distancia.
- La luz: un lado más oscuro que el otro, a veces la sombra de una mano o del teléfono y a veces un reflejo.
- La foto final: desenfoque, a veces movimiento, ruido y compresión JPEG.
Cada paso elige sus valores al azar, así que no hay dos fotos iguales. En un 30 % de ellas, además, las palabras de cada renglón se cambian por palabras de la Torá elegidas al azar. Así, la red no puede adivinar una palabra por las anteriores y tiene que leer cada letra.
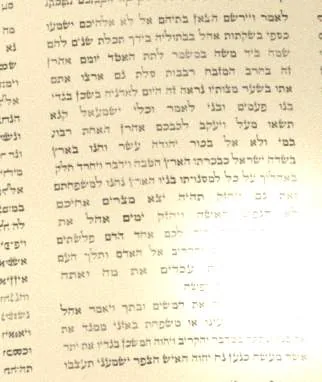
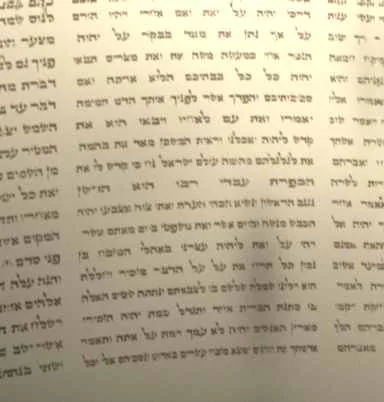
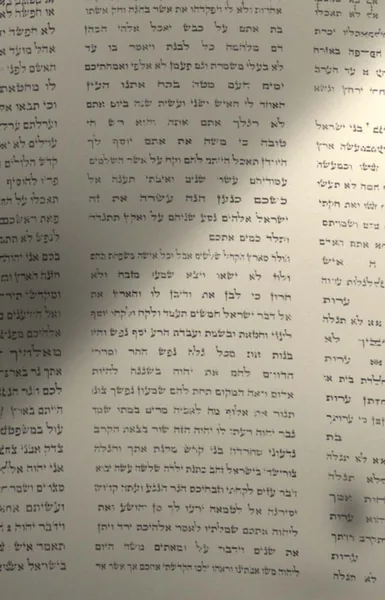
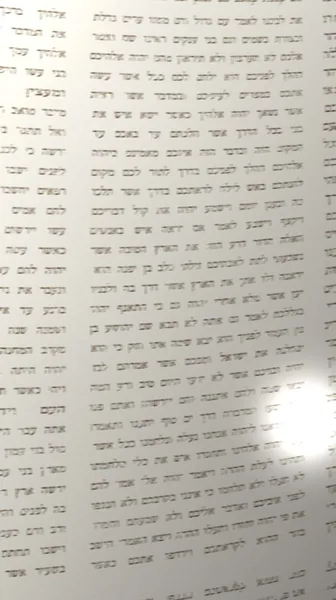
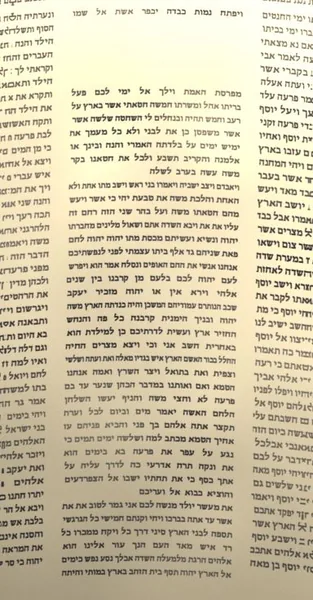
Las fuentes
Las fuentes son de Culmus, un proyecto de fuentes hebreas libres. Las dos de STA"M, Stam Ashkenaz y Stam Sefarad, aparecen en casi dos de cada tres fotos. El resto son fuentes de libros, para que la red vea otras formas de las mismas letras.
Stam Ashkenaz
37% de las fotos
Stam Sefarad
26% de las fotos
Keter YG
11% de las fotos
Frank Ruehl
7% de las fotos
Drugulin
4% de las fotos
Hadasim
4% de las fotos
Shofar
4% de las fotos
David
3% de las fotos
Simple
1% de las fotos
Miriam
1% de las fotos
Nachlieli
1% de las fotos
Yehuda
1% de las fotos
De la foto al renglón
La red lee de a un renglón. Para cortar los renglones de cada foto usamos el mismo código que corre en la app (son los pasos 2 a 5 del artículo sobre cómo funciona). Como el script sabe qué texto escribió en cada renglón y dónde quedó ese renglón después de deformar la foto, a cada recorte le pone su texto. Si un recorte no coincide bien con un renglón, se descarta, para que la red no aprenda de una etiqueta equivocada.
ויעש יריעת עזים לאהל על המשכן עשתי עשרה
ערת תחשים מלמעלה ויעש
אל אחת כן עשה לכל קרשי המשכן ויעש את
זה בחרב המזבח רבבות סלת גם ארצו אתםpalabras mezcladas
El entrenamiento
Armamos 4.000 fotos para entrenar y 300 para ir midiendo cómo aprendía. La red es chica (unos 450.000 parámetros) y se entrenó en el procesador de una computadora, sin placa de video. La versión que usa la app recorrió 5 veces todos los renglones de entrenamiento.
Para entrenar se usa la pérdida CTC. Es decir, a la red solo le hace falta el texto de cada renglón, sin saber en qué lugar de la tira está cada letra.
Cómo medimos si aprendió
Para medir usamos tres tipos de fotos, y ninguna se usó para entrenar:
- Fotos sintéticas nuevas: 200, armadas igual que las de entrenamiento pero aparte, todas con texto real.
- Sifrei escaneados: cuatro sifrei completos, publicados con licencias libres.
- Fotos sacadas con el teléfono: 10 cuadros de dos pruebas que grabamos, en un sefer gastado y en un tikún impreso.
Con las fotos sintéticas, la app ubicó con confianza el 95,5 % y nunca dio un lugar equivocado. La red se equivocó en el 14,9 % de las letras.
Los sifrei reales
Las fotos sintéticas no alcanzan para saber cómo le va a la red con un sefer de verdad. Por eso la probamos con escaneos completos de cuatro sifrei:
- El sefer de Elihu Shannon: Elihu Shannon es un sofer del kibutz Saad, en Israel. En 2011 mandó las fotos de todas las columnas de su segundo sefer Torá para publicarlas en Wikimedia Commons, con permiso para usarlas libremente. Ese sefer sigue el formato estándar de 245 columnas de 42 renglones, así que para cada foto sabemos exactamente qué columna es. Por lo tanto, es una prueba que ya trae las respuestas.
- El sefer de David Kokhav: lo encargó el rabino David Kokhav. Está escrito sobre guevil y sigue la costumbre de los sifrei yemenitas, en 226 columnas.
- Un sefer alemán de alrededor de 1920: restaurado por Makhon Ot, con 190 columnas que no siguen el formato de hoy.
- El manuscrito Or. 1462 de la British Library: un sefer del siglo XV, escrito en letra oriental por un sofer del que no se sabe el nombre. Las fotos muestran hojas enteras, con cinco a siete columnas cada una, así que las cortamos en columnas sueltas.
Con los tres últimos no sabemos de antemano qué columna es cada foto, pero sí sabemos que las columnas van en orden. La prueba, entonces, es que cada columna que la app ubica con confianza quede después de la anterior.
El sefer de Elihu Shannon
Kibutz Saad, Israel, 2011. Formato estándar.
Bereshit 1:1 · Bereshit · columna 1
Foto: Elihu Shannon, Wikimedia Commons, CC BY-SA 3.0.
El sefer de David Kokhav
Costumbre yemenita, 226 columnas.
Bereshit 1:1 · Bereshit
Foto: rabino David Kokhav, Wikimedia Commons, CC BY-SA 3.0.
Un sefer alemán
Alrededor de 1920, restaurado por Makhon Ot. 190 columnas.
Bereshit 14:20 · Lej Lejá
Foto: Internet Archive, CC0.
En el sefer de la British Library se ve bien la prueba del orden. Abajo hay una hoja entera y sus siete columnas, recortadas una por una. La app ubicó las siete con confianza, una después de la otra, de Terumá a Ki Tisá.
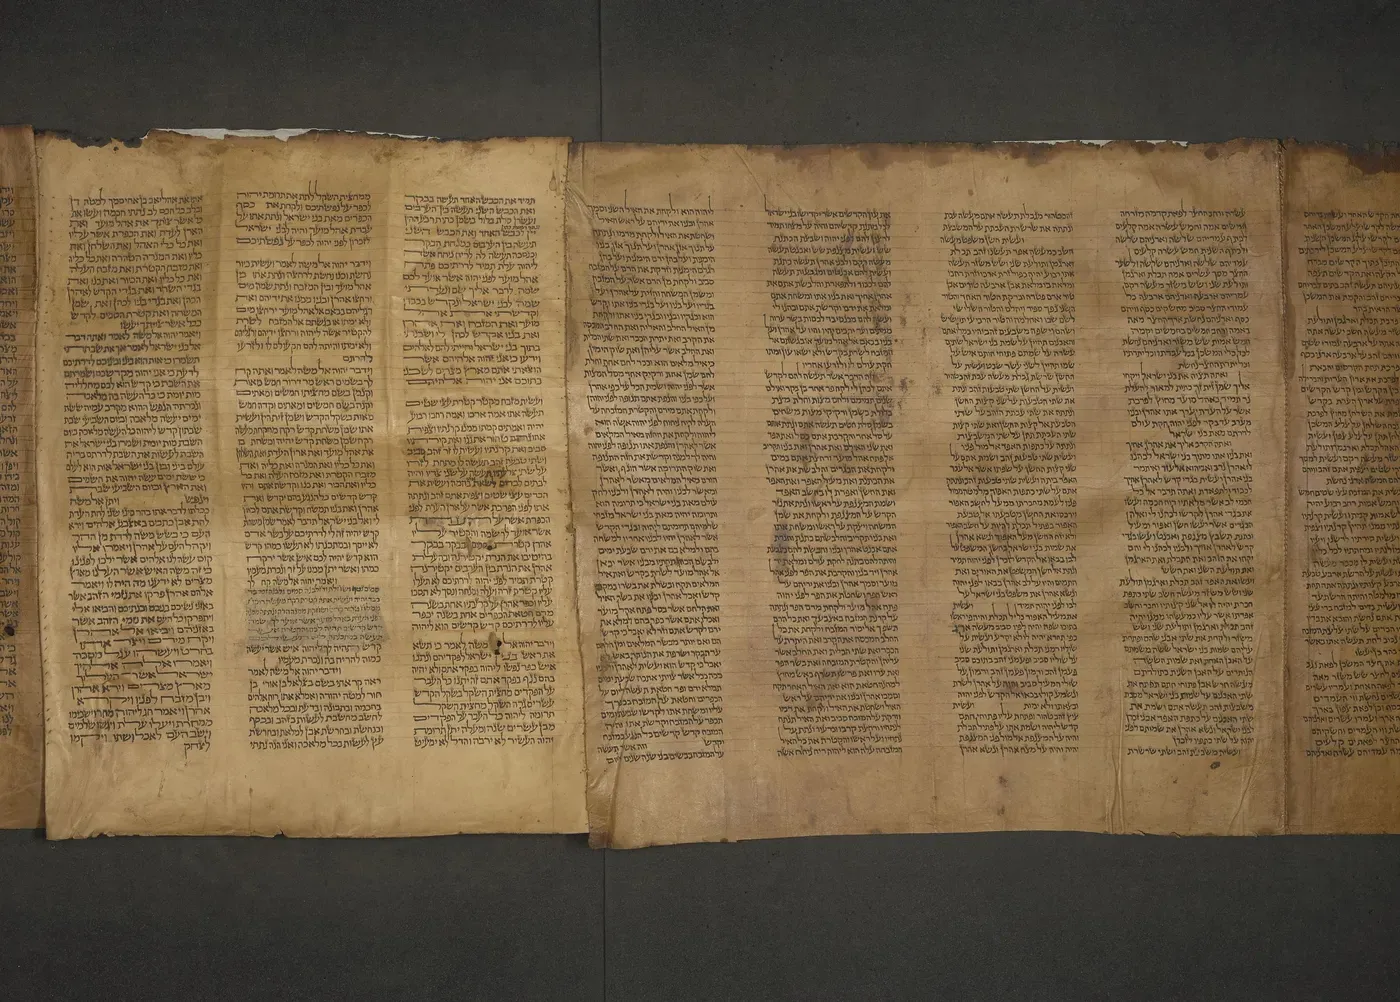
Foto: British Library, MS Or. 1462, en Internet Archive. Dominio público.
Terumá
27:13
Tetzavé
28:15
Tetzavé
28:38
Tetzavé
29:19
Tetzavé
29:38
Ki Tisá
30:15
Ki Tisá
31:6
Los resultados
| Sefer | Fotos | Ubicadas con confianza | Equivocadas o fuera de orden | Sin respuesta |
|---|---|---|---|---|
| Elihu Shannon | 246 | 241 | 0 | 5 |
| David Kokhav | 226 | 225 | 0 | 1 |
| Makhon Ot, Alemania | 190 | 189 | 0 | 1 |
| British Library, siglo XV | 233 | 187 | 0 | 46 |
En el sefer de Shannon, 240 de las 241 dieron además el número de columna exacto. Las que quedaron sin respuesta son las dos canciones escritas en forma de ladrillos (Shirat HaIam y Haazinu), que el buscador de renglones no sigue, y los nesiim de Bamidbar 7, donde dos columnas se parecen demasiado.
En el de la British Library hay 21 columnas que quedan antes de la anterior, pero todas son la primera columna de una foto nueva. De esas, 16 caen sobre una columna que ya estaba, porque una foto repite el final de la anterior, y 5 completan huecos que habían quedado. Ninguna contradice a sus vecinas.
Las fotos sacadas con el teléfono
Por último, probamos con 10 cuadros de dos pruebas grabadas con el teléfono, en un sefer gastado y en un tikún impreso. Son grabaciones de pantalla de baja resolución, con renglones de unos 17 a 23 píxeles de alto. La app ubicó los 10 sin ningún error, aunque la red se equivocó en cerca del 30 % de las letras (contando cada ? como error).
Lo que más puede mejorar la red son fotos reales. Por eso, cuando un escaneo no sale bien, la app ofrece mandar la foto para sumarla al entrenamiento. Solo se manda si la persona lo marca.
El código
Las fotos sintéticas de este artículo salen del mismo código que armó el set de entrenamiento (tools/train), y los dibujos sobre los sifrei reales salen de correr la app sobre cada foto (tools/eval). Los resultados completos están en la evaluación.