Es viernes y hay que dejar el sefer listo para Shabat. Quedó abierto en Masei, al final de Bamidbar, y mañana se lee desde Devarim 1:1. NavTorá resuelve justamente eso. Con una foto de la columna abierta, te dice dónde está el sefer, cuántas columnas hay que enrollar y para qué lado.
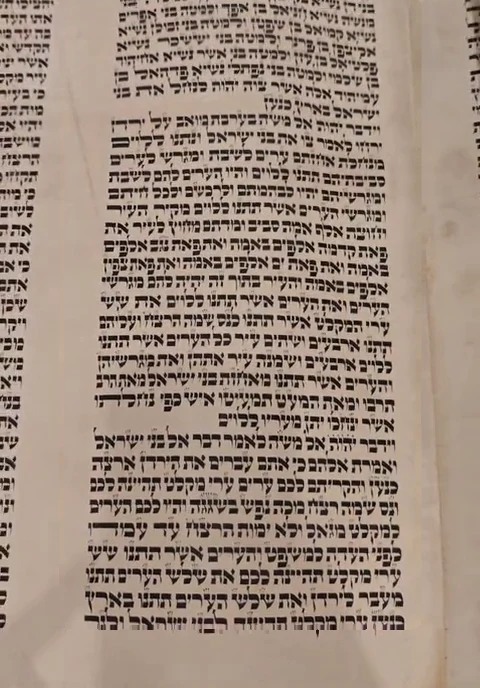
Para ubicarse, la app lee la columna (con errores y todo) y busca esas palabras entre las 80.316 de la Torá. No necesita tener guardado cómo se ve cada columna, así que sirve para cualquier sefer. La foto de este artículo es un cuadro real de una de las pruebas que grabamos, y lo que está dibujado encima sale de correr el código de la app sobre ella.
Paso 1La foto
La foto es un cuadro de la grabación de pantalla de una de nuestras pruebas, recortado a lo que mostraba la cámara (le borramos la guía amarilla de la app). Tiene 480 por 688 píxeles, más o menos la cuarta parte de la resolución con la que la app saca las fotos. El pergamino está amarillento y tiene manchas, la columna se ve más angosta arriba que abajo porque el teléfono no estaba paralelo al sefer, y los renglones se curvan un poco porque el pergamino no está plano. A los costados, además, se ven partes de las columnas vecinas.
En la app, todo lo que sigue hasta tener el texto leído pasa en el teléfono, y la foto no se manda a ningún lado.
Paso 2Separar la tinta del pergamino
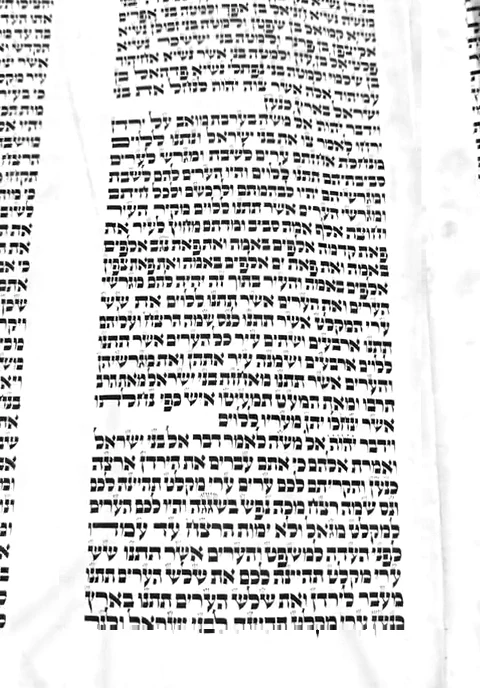
Lo primero que hace la app es sacarle a la foto el efecto de la luz. El brillo del pergamino cambia despacio a lo largo de la foto (una sombra de un lado, una lámpara del otro, una mancha), mientras que la tinta cambia de golpe, de un píxel al siguiente.
Para separarlas, la app hace una copia chiquita de la foto, de 160 píxeles de lado. En esa copia, cada punto toma el valor más claro de sus vecinos. Como las letras son finitas, desaparecen, y queda solo el fondo. Después, la app divide la foto por ese fondo. Es decir, donde hay pergamino el resultado queda blanco y donde hay tinta queda oscuro, esté a la sombra o al sol.
Si arrastrás la línea sobre la foto, vas a ver que las manchas y el amarillo desaparecen y las letras quedan.
Paso 3Encontrar la columna
En la foto se ven partes de tres columnas, y la que nos interesa es la del medio. Para encontrarla, la app suma la tinta de arriba a abajo en cada posición horizontal. Esa suma está dibujada abajo de la foto. Donde hay texto es alta, y en los márgenes en blanco que separan las columnas es casi cero.
La columna es el tramo con texto que contiene el centro de la foto, entre dos de esos huecos. Como el teléfono puede estar torcido, antes de sumar la app prueba inclinar la suma unos grados para cada lado y se queda con el ángulo que deja los bordes más nítidos. También mide los bordes en varias franjas de altura por separado (en esta foto, 5), para que sigan la perspectiva. La columna mide 265 píxeles de ancho arriba y 317 abajo.
Paso 4Seguir cada renglón
En un sefer, los renglones se apoyan en el sirtut, las rayas que el sofer marca antes de escribir. Por eso son paralelos y están a la misma distancia, y la app aprovecha eso.
Primero mide esa distancia. Corta la columna en seis tiras angostas, suma la tinta fila por fila en cada una y busca cada cuántos píxeles se repite el patrón. En esta foto, los renglones están cada 20,2 píxeles.
Después corta la columna en tiras más anchas (en esta foto, 3). En cada una, la suma fila por fila da un pico por renglón (a los costados de la foto están esas sumas para la primera y la última tira). Si el teléfono está torcido o el pergamino se curva, los picos de una tira no caen a la misma altura que los de la tira de al lado. Comparando tiras vecinas, la app mide cuánto sube o baja cada renglón de una a otra y con eso arma el camino de cada uno. En esta foto encontró 28 renglones.
Paso 5Recortar y enderezar
Cada renglón se recorta siguiendo su camino, como si se estirara el pergamino con los dedos, y queda en una tira de 32 píxeles de alto. Así, las curvas desaparecen.
Además, la tira se da vuelta como en un espejo. ¿Por qué? Porque la red que lee recorre la tira de izquierda a derecha, y el hebreo se escribe de derecha a izquierda. Dada vuelta, la primera letra del renglón queda primera y el texto sale en orden.
Como la recibe la red
Dada vuelta, como la leemos
Paso 6Leer letra por letra
Para leer, la app usa una red neuronal chica, de 1,8 MB, que corre en el teléfono (la primera versión leía con Claude, y lo cuento en otro artículo). Unas capas convolucionales miran la forma de los trazos, y una LSTM, que mira hacia los dos lados del renglón, suma el contexto. La red avanza por la tira de a 4 píxeles y en cada paso dice qué letra cree ver, o «nada».
Para pasar de pasos a letras, se juntan las repeticiones y se borran los «nada» (esto se llama decodificación CTC). Si en un tramo la letra más probable no llega al 50 %, la app no se la juega y escribe ?.
↓ se juntan las repeticiones y se borran los «nada»
- Leyó
- בנ??ה
- En el sefer
- מנחלת
↓ se juntan las repeticiones y se borran los «nada»
- Leyó
- אחזתם
- En el sefer
- אחזתם
En la primera palabra, la red leyó ב donde dice מ, y ה donde dice ת (dos letras que en STA"M se parecen). En otras dos letras dudó, y quedaron como ?. En la segunda palabra, la א aparece en dos pasos seguidos y cuenta como una sola, y la palabra sale perfecta.
La red no se sabe la Torá de memoria. Se entrenó solo con fotos sintéticas, armadas con columnas reales escritas con fuentes STA"M y envejecidas por computadora, con manchas, sombras, reflejos y curvas. En un 30 % de esas fotos las palabras estaban mezcladas al azar. De esa forma, la red no puede adivinar la palabra siguiente por el contexto y tiene que leer cada letra. Cómo se arman esas fotos, y cómo la probamos con sifrei reales que nunca vio, está en Cómo entrenamos la red que lee el sefer.
Por eso se equivoca bastante. Sobre la foto está lo que leyó en cada renglón, y hay mucho naranja, sobre todo abajo, donde la foto está más borrosa. Sin embargo, para el paso siguiente no hace falta una lectura perfecta.
Paso 7Buscar entre 80.316 palabras
Lo leído tiene errores, como יהות en vez de יהוה o ביואב en vez de מואב. Por lo tanto, buscar el texto tal cual no serviría. En cambio, cada palabra leída vota dónde empieza la foto. Esta parte ya pasa en el servidor, que recibe el texto y no la foto.
Por ejemplo, לערים es la palabra 39 de lo leído, y en la Torá está en la posición 65.300. Entonces vota que la foto empieza en la posición 65.262. Las palabras raras pesan más que las comunes (לערים aparece 2 veces en toda la Torá, y את, 2.622 veces), y las palabras parecidas también votan, un poco menos. Con 216 palabras votando, los votos se amontonan en un solo lugar.
Alrededor de los lugares más votados, la app compara palabra por palabra, como cuando se comparan dos versiones de un mismo texto. Esa comparación tiene en cuenta que en letra STA"M es fácil confundir ב con כ, ד con ר o ה con ח, y que ? puede ser cualquier letra, así que esos errores cuestan poco.
Paso 8¿Está segura?
Encontrar un lugar no alcanza para dar una respuesta. La app pide un mínimo de palabras alineadas en más de un renglón y compara el mejor lugar con el segundo. Acá el mejor (Masei, columna 198) sacó 147,2 puntos contra 15 del segundo, con 179 palabras alineadas en 27 renglones.
Cuando los dos primeros se parecen, la app no adivina. Esto pasa, por ejemplo, en Bamidbar 7, donde la ofrenda de cada uno de los doce nesiim se repite casi igual. En ese caso, la app muestra las opciones y pide otra foto, mejor si se ve el principio de la columna. En 2.000 pruebas simuladas con hasta la mitad de las letras mal leídas, nunca dio un lugar equivocado con confianza.
Paso 9Para qué lado mover el sefer
El resultado de todo esto es una posición en palabras, que sirve para cualquier sefer. Para contar columnas, la app usa el formato estándar de 245 columnas. Esta foto es de la columna 198, y Devarim 1:1 está en la 200.
Como el texto va de derecha a izquierda, ir hacia Devarim es ir hacia la izquierda, en este caso 2 columnas. Si el sefer sigue el formato estándar, la cuenta es exacta. Si no, es una aproximación, y conviene volver a escanear. Al llegar, la app te dice en qué renglón empieza la lectura.
¿Qué se manda al servidor?
El texto leído y algunos datos del escaneo (cuánto tardó, qué lectura buscabas y un número al azar que identifica al teléfono). La foto se queda en el teléfono, salvo que alguien la mande a propósito para ayudar a mejorar la red.
Lo que todavía no hace bien
- Las dos canciones escritas en forma de ladrillos, Shirat HaIam y Haazinu, porque el buscador de renglones no las sigue.
- Los pasajes que se repiten, como el de los nesiim. Ahí la app avisa que hay más de una opción en lugar de elegir una.
- Los sifrei que no siguen el formato estándar. La app cuenta las columnas siempre con el formato estándar de 245 columnas, y todavía no detecta cuando un sefer tiene otro. En esos sifrei la cuenta puede no coincidir, así que conviene escanear de nuevo cuando llegás.
El código
El código es abierto y está en GitHub. Los resultados de cada prueba están en la evaluación, y el script que generó las figuras de este artículo está en tools/eval. Ese script corre en una computadora el mismo código que la app corre en el teléfono. Las sumas de tinta de los pasos 3 y 4, los votos y la comparación palabra por palabra están recalculados con el mismo método para poder dibujarlos.